 TFCookbooks
每个环节都变快了,为什么交付没有一起变快
过去一年多,几乎每个团队都做过同一件事:把 AI 接进自己的工作流。其中提速最明显的,是写代码——Claude Code、Codex、TRAE 这一类工具,已经不只是「补全一行」,而是「你把活派给它,它自己做」。
单看这一步,确实快了。可交付呢?不是某一步,是整件事做完的时间——它动了多少?
答案通常不是「没动」。局部确实快了一截,但整条线不像是跟着一起变短。而且这不是感觉——这件事已经被量过了,还不止一次。
两个公开的数字
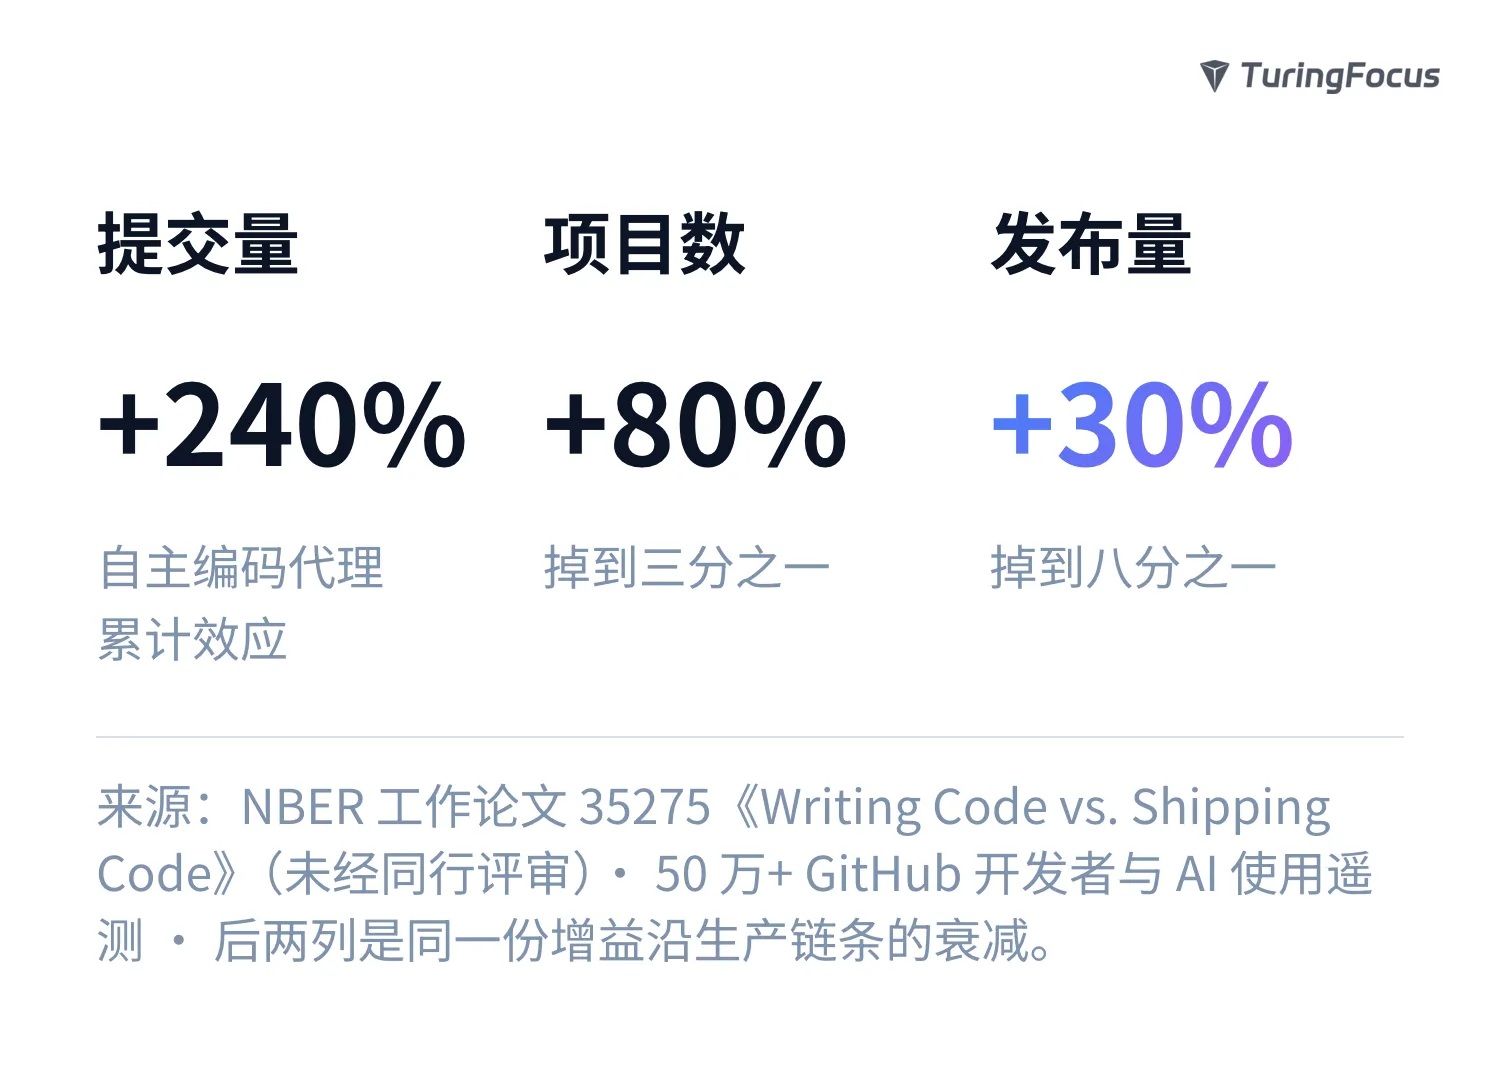
第一个来自一份 NBER 的工作论文。《Writing Code vs. Shipping Code》——MIT 和沃顿的三位作者,用 GitHub 上 50 万+ 开发者的提交记录,配上他们使用 AI 工具的遥测数据,做的一项配对事件研究。工作论文口径,未经同行评审。
按这份论文的口径,三代工具(代码补全、交互式编码代理、自主编码代理)带来的提交量增长,累计分别是 30%、180%、240%。但同一份增益沿着生产链条往下走,掉得极快:240% 到「项目数」只剩 80%,到「实际发布」只剩 30%——八分之一。
他们给这个现象起的名字是薄弱环节假说:AI 的增益不是假的,是被链条上人的瓶颈一级一级吃掉的。论文里估出的替代弹性是 0.23——AI 和人不是替代关系,是强互补:写快的部分交出去,要判断的部分还得人来。
还有一句更扎的:在四个主要应用市场里,新应用的数量激增,总使用量却没有增加。
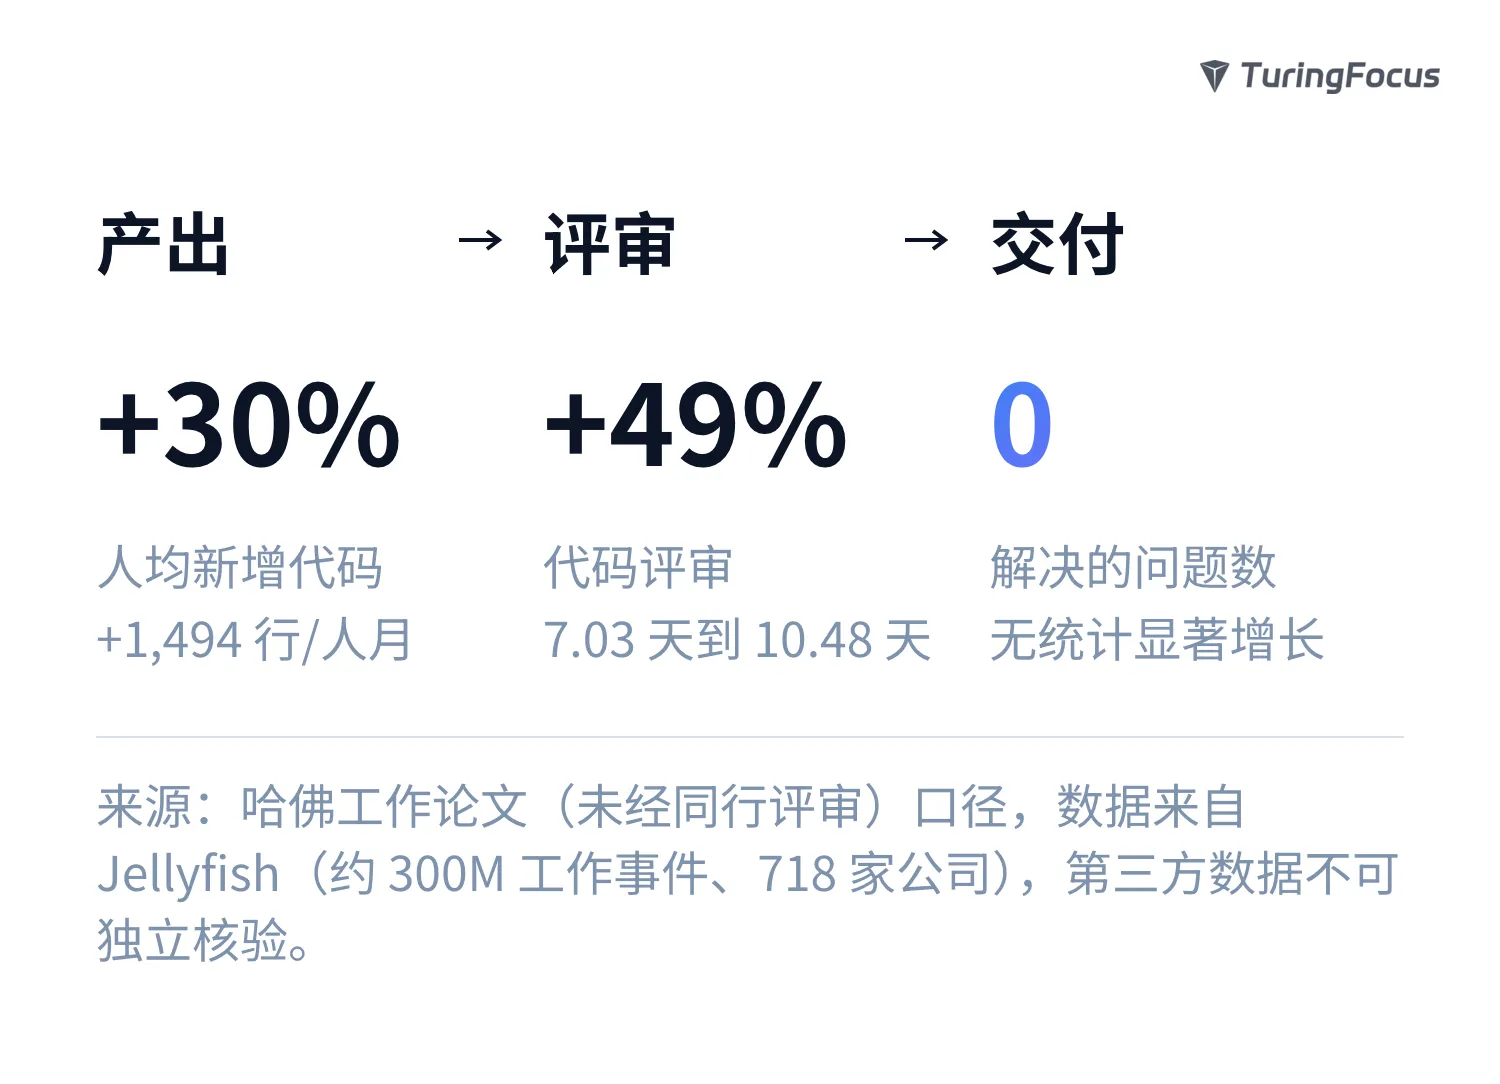
第二个来自一份哈佛的工作论文。《Artificial Intelligence in the Firm: Bottlenecks in Software Production》,用的是 Jellyfish 的工程数据——约 300M 条工作事件、72 万余名开发者、718 家公司。工作论文口径,未经同行评审,数据来自第三方、不可独立核验。
它的发现是,引入 AI 编程之后:
- 每月人均新增代码约 +1,494 行(约 +30%),提交 +20%,PR +23%;
- 代码评审时间从 7.03 天涨到 10.48 天(+49%)——等一次代码评审,从「周一提交、下周一得出结论」变成「还要再压着一个周末」;
- 解决的问题数没有统计上显著的增长(估计 +0.12 个/人月,基线 3.67,置信区间排除了超过 12% 的提升)。
产出涨了三成,评审慢了一半,交付纹丝不动。这份论文给这个现象起的名字很直白:review tax,评审税。
三个数摆在一起才是完整的故事:30、49、0。按这份论文的统计口径:多写出来的那 30%,到评审那里付出 49% 的等待,最后落在交付上是 0——多写的那部分代码,没有可证实的比例变成了「做完的事」。这是它最扎眼的地方,也是接下来最该被拆开的一环。
卡住的那一环,叫决策
写完一个函数,不难。难的是决定它该不该进主干——和现有设计冲不冲突、有没有更简单的做法、三个月后还改不改得动。
按那份论文的统计,评审时间涨的那 49%,涨的不是「读代码」的时间,是做决策的时间。
这一环,现在所有 Agent 都帮不上。但原因值得说清楚:不是它不够聪明。
代码这件事,它为什么行
一个 Agent 打开一个代码仓库的时候,它面前是什么?
是一个能被完整读下来的东西。目录结构、每一行代码、提交历史、issue、测试、注释、文档——全在同一个地方,全是文本,全是它能直接读的形式。它想知道「这个函数该怎么改」,需要的依据基本都摊在眼前。
这份文本的规矩还极严:逻辑必须走通,对不对跑一下就知道。一个写坏的改动不需要谁来评理,测试会说话。而且它永远是最新的——仓库里的东西,就是此刻真实在跑的东西。
再往深一层:工程师这十几年攒下的工具,加上几乎全部公开的代码历史,本身就是它的训练语料。它见过的代码,比任何一个活着的程序员都多。
所以它在代码上的行,很大一部分是代码这个领域自己喂出来的。就像人天生会说话、会微笑——不是这个领域更难或更简单,是这里的上下文恰好是敞开的。
换个岗位,上下文就不在眼前了
同样是一个「该不该」,换到别的岗位,它面前有什么?
问「这个方案该不该上」,依据在哪?在某个业务系统的数据里,在上个季度的一次会上,在某个待了很久的人脑子里——分散、没被记过、也不在同一个地方。有的东西甚至从来没被写下来过,只在几个人之间口口相传,来一个新人才讲一遍。
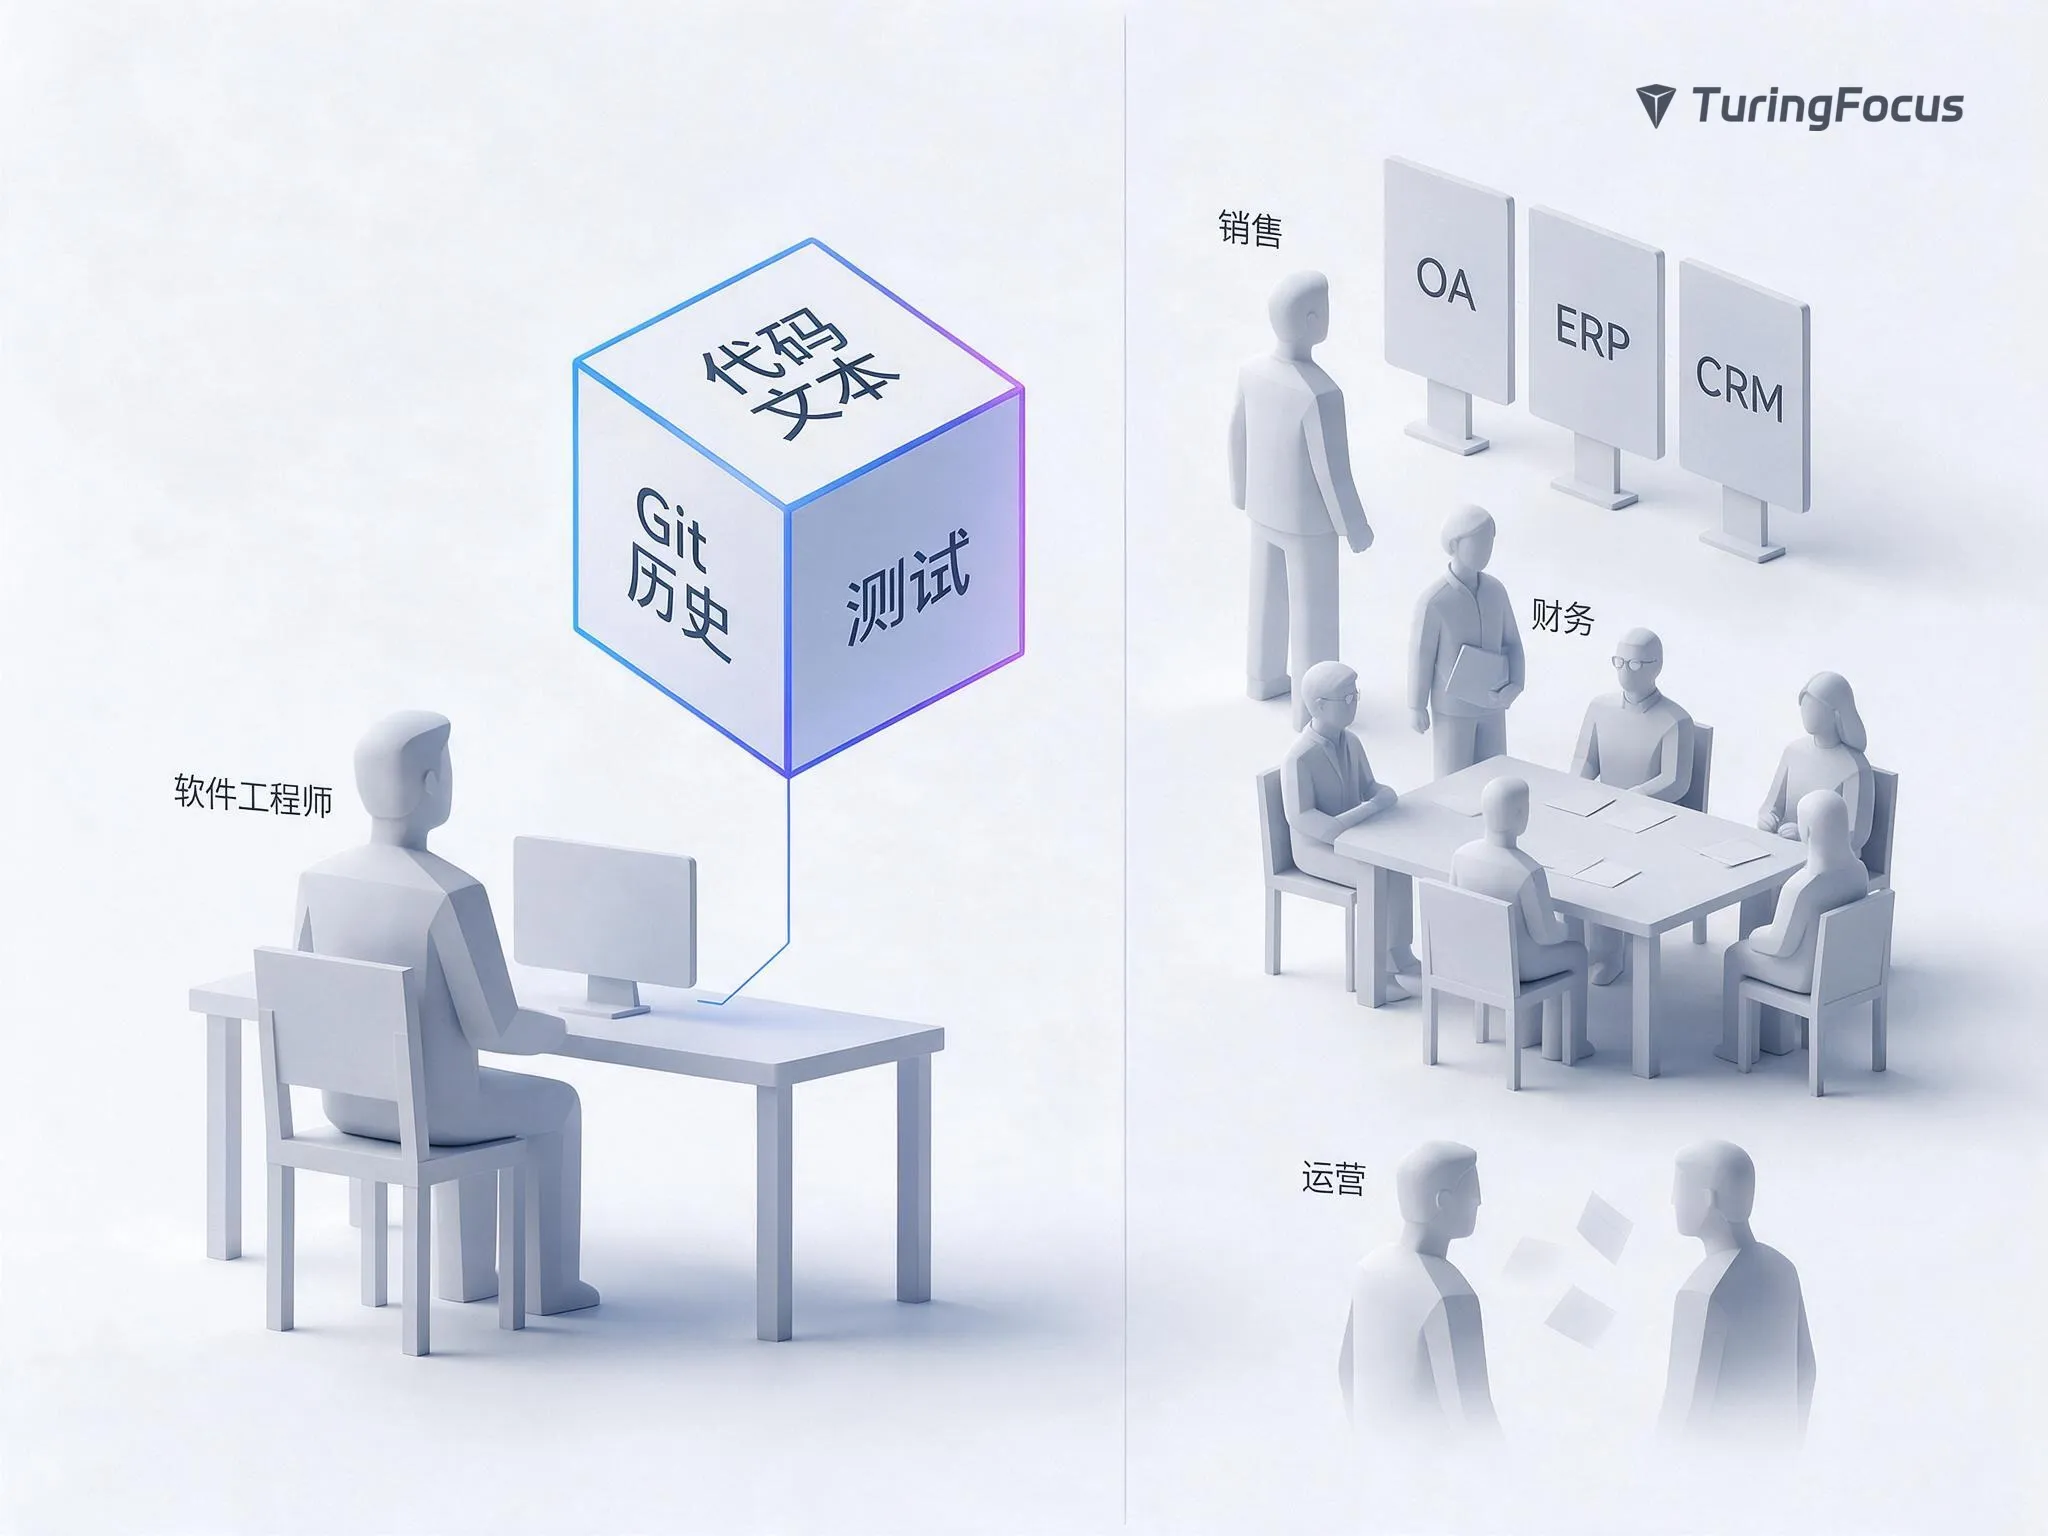
Agent 拿不到这些,就只能靠它自己那点常识去补。那不是决策,那是猜测。
看不到决策的依据,看不到决策的标准,也看不到这家公司的决策习惯——它就做不出决策。
这跟聪不聪明没关系。再聪明,也解决不了「依据根本不在眼前」这件事。
按同一份论文的统计:到 2026 年 3 月,80% 的公司在用 AI 做代码评审;但所有评审意见里,AI 生成的只占 23.3%。
工具进了四家公司,写出来的意见不到四分之一。买到的部分在干活,要拍板的那部分,还是人。
工具能识别「这里有个 bug」,识别不了「这里该不该这么设计」——后者的依据,不在这段代码里。
已经有人在做「帮决策」的 Agent 了
不是一片空白。至少在国内,已经有人把 Agent 从生产侧往决策侧挪:
- 中科闻歌在 WAIC 2026 发布了「决策机 Decitron」,做深度分析、模拟推演与方案比选;
- 零一万物发布「一号位决策 AI」产品矩阵,面向经营、增长、投资三类决策场景;
- 黑湖科技把决策型 Agent 放进工厂,覆盖报价、排程、跟单、质检。
它们有个共同点:都把决策绑在很具体的行业上——工业、投资、经营。这大概不是巧合。
决策比生产难通用,因为它要的那些依据太本地了:同一个数字,放在工厂里和放在投资里,含义完全不同——在工厂,它是排产要动的问题;在投资,它是这家公司值不值得继续看下去的信号。
但**「依据本地」和「一家一套」是两件事**:依据本地是事实,决策本来就是这样;一家一套是代价——本地的那部分,眼下只能一笔一笔地写进去,多接一个行业,就多写一遍。
所以,好 Agent 的标准,就看它怎么把这个代价消掉。
那么,一个好的 Agent 该长什么样
前面三家已经把 Agent 挪进了决策。所以问题不再是「能不能」,是**「什么样才算好」**——标准落到两个问题上:它怎么进一家公司?进去之后能干什么?
「怎么进」,有两条。
它得是框架,不是定制。 决策不是一成不变的——业务变了、人变了、行情变了,判断标准就得跟着变。而一家一套定制出来的东西,改不动。所以角色、流程、依据,都该是搭出来的,不是写死的:换一家公司、换一个岗位,改的是配置,不是重写一套系统。角色是搭出来的,不是定制出来的。
它得是这家公司自己的。 决策依据里最要紧的那部分,往往是机密——成本怎么算、客户是谁、遇事怎么权衡,还有那些从没被写下来、只在几个人之间口口相传的标准。这部分不会出门:公司的决策依据和数据,本来就不该交到第三方手里。所以「谁来说、谁来改」,必须落在公司自己身上——业务的人自己说得出来、改得动,这个 Agent 才算真的进了门。反过来,如果这套东西要靠外部派人力来搭:买的是人力不是产品,成本不可控、周期不可控,改一处还得再求一次人。而且最清楚这家公司怎么拍板的,本来就在这家公司里。
「能干什么」,也有两条。
它得覆盖到各个岗位,不只工程师。 生产侧的 Agent 已经很成熟——这是真的:写代码那一个岗位,它已经能整件事接过去。但成熟的是一个岗位,不是一家公司。除了工程师,还有采购、销售、财务、法务、运营——每个岗位每天也都在做「该不该」的判断。只帮生产,不算好;只帮工程师,更不算好。
它还得会决策。 要做到这一点,它得先把那些散在外面的决策依据,变成自己拿得到的东西:
- 它得看得见现在。 业务系统里正在发生什么,是决策的第一层依据。
- 它得记得住过去。 上次为什么这么做、当时否决了什么。记不住的 Agent,每次都从零开始,永远长不出这家公司的决策习惯。
- 它得学得会这家公司怎么拍板。 那些没有写在任何文件里的标准,最终得从人那里进到它那里。
- 它的决策得能被复核。 人得看得出它凭什么这么定,不同意的时候能插手。
这四件都不在模型里,在模型外面。
更好的上下文组织引擎
上面这几件事,没有一件是「换一个更强的模型」能解决的。它们指向同一个东西:一个更好的上下文组织引擎。
模型知道的是它训练时见过的那个世界;而决策需要的,是此刻的世界,是这家公司此刻的样子。把后者搬到它面前,是引擎的事。
这个引擎至少得管好两件现在还没人管好的事:
- 客观世界的内容,怎么被召回、怎么被组织。 依据不是查出来就完了——它得被排成能支撑这一次决策的样子。同样的材料换个排法,结论可能就变了。
- 工具怎么生长、怎么在运行时被管住。 Agent 能动手,靠的是一整套工具。这些工具怎么长出来、什么时候该用哪一个、用完怎么收回来,本身就是它上下文的一部分。
回到那句话:大模型的重点是预测下一个 Token;Agent 的重点是组装最优的 Context。这句话在生产侧看着像句正确的废话——反正代码写出来就行。到了决策这一环,它才变成真问题:决策的质量,几乎完全取决于上下文组装的质量。
这也是我们选择要解决的那一类问题。接下来几篇会一件一件拆开讲:这个引擎怎么组装上下文、怎么记住又找回、怎么把一堆互不相识的部件连成一体。
在拆开之前,先说清这个引擎要的那件事叫什么:精准。
一节装反的电池
前几天给我儿子讲一本科普书,里面有一道题:手电筒里装着四节电池,其中一节装反了,会怎么样?
几个孩子各答各的。一个说会变暗,一个说就完全不亮了,还有一个说会爆炸。
只有第一个答对了。装反的那节不会消失,它反过来抵消掉一节正向的——四节的电,剩下两节的亮。要是本来只有两节、再装反一节,正负相消,就真的不亮了。
想想这个直觉差在哪:孩子都知道「少了会变暗」,但没想到**「装反了会抵消」**。少的,是被打折;错的,是反向的阻力。
上下文也是这样。不准确的上下文不是「少了一块」,是多了一块错的方向——它不光是让这一步变弱,还会主动往下拽,拉着整个上下文一起变差。
但精准不只是「别装错」。还有一样更隐蔽的浪费:多出来的材料没有错,只是没用。它不拽谁,可它占着注意力——注意力是有预算的,花在多余材料上的那一份,本该花在要紧的几块上。堆得越多,要紧的几块越不显眼。
所以「组装上下文」这五个字的重点在精准上:不是把材料堆够,也不只是每一块都装对方向——是不多不少,恰到好处。
两句话
大模型的使命,是精准地预测下一个 Token。
Agent 的使命,是精准地组装当前的上下文。
两句都是关于精准,但对象完全不同:一个面向它训练时见过的世界,一个面向此刻、这家公司、这件事的真实处境。谁也不是谁的附属。
想明白这个,有些担心就不必了:模型的能力再往上翻,也不会把 Agent 变成多余——恰恰相反,模型越强,装在它对面前的东西对不对,越值钱。
接下来
我们一起展开:如何设计一个可以覆盖任意岗位、能干活、也能决策的 Agent 系统。
要接上的,就是从生产到决策的那一段路:先把散在各处的依据变成它拿得到的东西,再让它在这些依据之上,长出这家公司的判断。
这条路我们才走了一小段——做对的、做错的、返工的,都会写在这里。